הנדסת קונטקסט 2026: המיומנות שהחליפה את הנדסת הפרומפטים
הנדסת קונטקסט החליפה את הנדסת הפרומפטים כמיומנות המרכזית של 2026. מה עובד היום, אילו טריקים כבר מזיקים, ומה זה אומר למפתחים בישראל.

שנה אחרי שהמונח "context engineering" הפך לוויראלי, הוא כבר לא באזוורד אלא תיאור משרה. הנדסת הפרומפטים הקלאסית, זו של ניסוחים חכמים ומשפטי קסם, איבדה את מקומה כמיומנות המרכזית בעבודה עם מודלי שפה. במקומה עלתה דיסציפלינה רחבה יותר: תכנון מכוון של כל מה שהמודל רואה בכל קריאת הסקה, מפרומפט המערכת ועד הזיכרון ארוך הטווח.
מה השתנה: מפרומפט בודד לניהול מצב שלם
נקודת המפנה מיוחסת לפוסט של אנדריי קרפתי ב-X מ-25 ביוני 2025, בהמשך לפוסט של טובי לוטקה, מנכ"ל Shopify. שניהם טענו שהמונח "prompt engineering" פשוט לא מתאר את העבודה האמיתית: בניית הקונטקסט המלא שהמודל מקבל, כולל קלט המשתמש, מסמכים שאוחזרו, היסטוריית שיחה, הגדרות כלים וזיכרון. שנה אחר כך, המונח נמצא בכל מקום, מהרצאות בכנסים ועד תארי משרה, וגרטנר הכריזה על 2026 כ"שנת הקונטקסט".
הסיבה לשינוי היא מעבר התעשייה מצ'אטבוטים לסוכנים. סוכן שרץ עשרות צעדים לא נכשל בגלל ניסוח גרוע של הוראה אחת, אלא בגלל ניהול מצב לקוי: קונטקסט שמתנפח, מידע קריטי שהולך לאיבוד באמצע, וכלים שמקבלים הגדרות סותרות. הכשלים של 2026 הם כשלי ניהול-מצב, לא כשלי פרומפט.
מי שעדיין מלטש ניסוחים של משפט פתיחה מפספס את העיקר. העבודה האמיתית היא להחליט אילו עשרת אלפים טוקנים נכנסים לחלון ואילו מאה אלף נשארים בחוץ.
הטריקים שכבר מזיקים
חלק גדול מארגז הכלים של 2023-2024 לא רק התיישן אלא הפך למזיק. הטריקים החכמים של פעם, כפי שמנסחים זאת בתעשייה, "עברו RLHF לאבדון": המודלים אומנו כך שהם כבר לא זקוקים להם, ולעיתים הם מוסיפים רעש שפוגע בתוצאה.
- פרסונות מפורטות מדי: פסקאות שלמות של "אתה מומחה בעל 20 שנות ניסיון" מוסיפות רעש. הגדרת תפקיד תמציתית ומיושרת לתוצאה הרצויה עובדת טוב יותר.
- פרומפטים ארוכים כברירת מחדל: מחקר מראה שביצועי היסק מתחילים להתדרדר סביב 3,000 טוקנים, הרבה מתחת למקסימום הטכני. נקודת המתיקות המעשית לרוב המשימות היא 150-300 מילים.
- few-shot אוטומטי: הדור הנוכחי של המודלים חזק מספיק כדי שכדאי לנסות zero-shot קודם, ולהוסיף דוגמאות רק אם יש כשל מדיד.
- הסתמכות על מודל "latest": התנהגות הראוטר משתנה בין גרסאות. אפליקציות פרודקשן צריכות להינעל לסנאפשוט ספציפי, למשל gpt-5-2025-08-07.
חלונות קונטקסט של מיליון טוקנים ב-Claude, Gemini ו-GPT-5.5 לא אומרים שכדאי למלא אותם. גדול יותר אינו טוב יותר: ככל שהחלון עמוס יותר, כך גדל הסיכון שמידע קריטי יטבע ברעש.
הטכניקות שעובדות היום
הטיית מיקום (position bias) היא כנראה הממצא העמיד ביותר בתחום. מודלים קשובים יותר לתחילת הקונטקסט ולסופו, וממצאי המחקר "Lost in the Middle" מ-2023 עדיין תקפים גם במודלים של מיליון טוקנים. המסקנה המעשית: קטע קריטי, כמו ההוראה המרכזית או המסמך החשוב ביותר, צריך לשבת בתחתית הודעת המשתמש, לא קבור באמצע.
טכניקה שנייה עם החזר כספי מיידי היא יציבות פרומפט המערכת. prompt caching של Anthropic חותך עד 90% מהעלויות ו-85% מהלייטנסי על הקידומת המקובעת. המשמעות ההנדסית: כל מה שקבוע, הוראות, סכמות, הגדרות כלים, צריך לשבת בתחילת הקונטקסט ולא להשתנות בין קריאות, כדי שה-cache יתפוס.
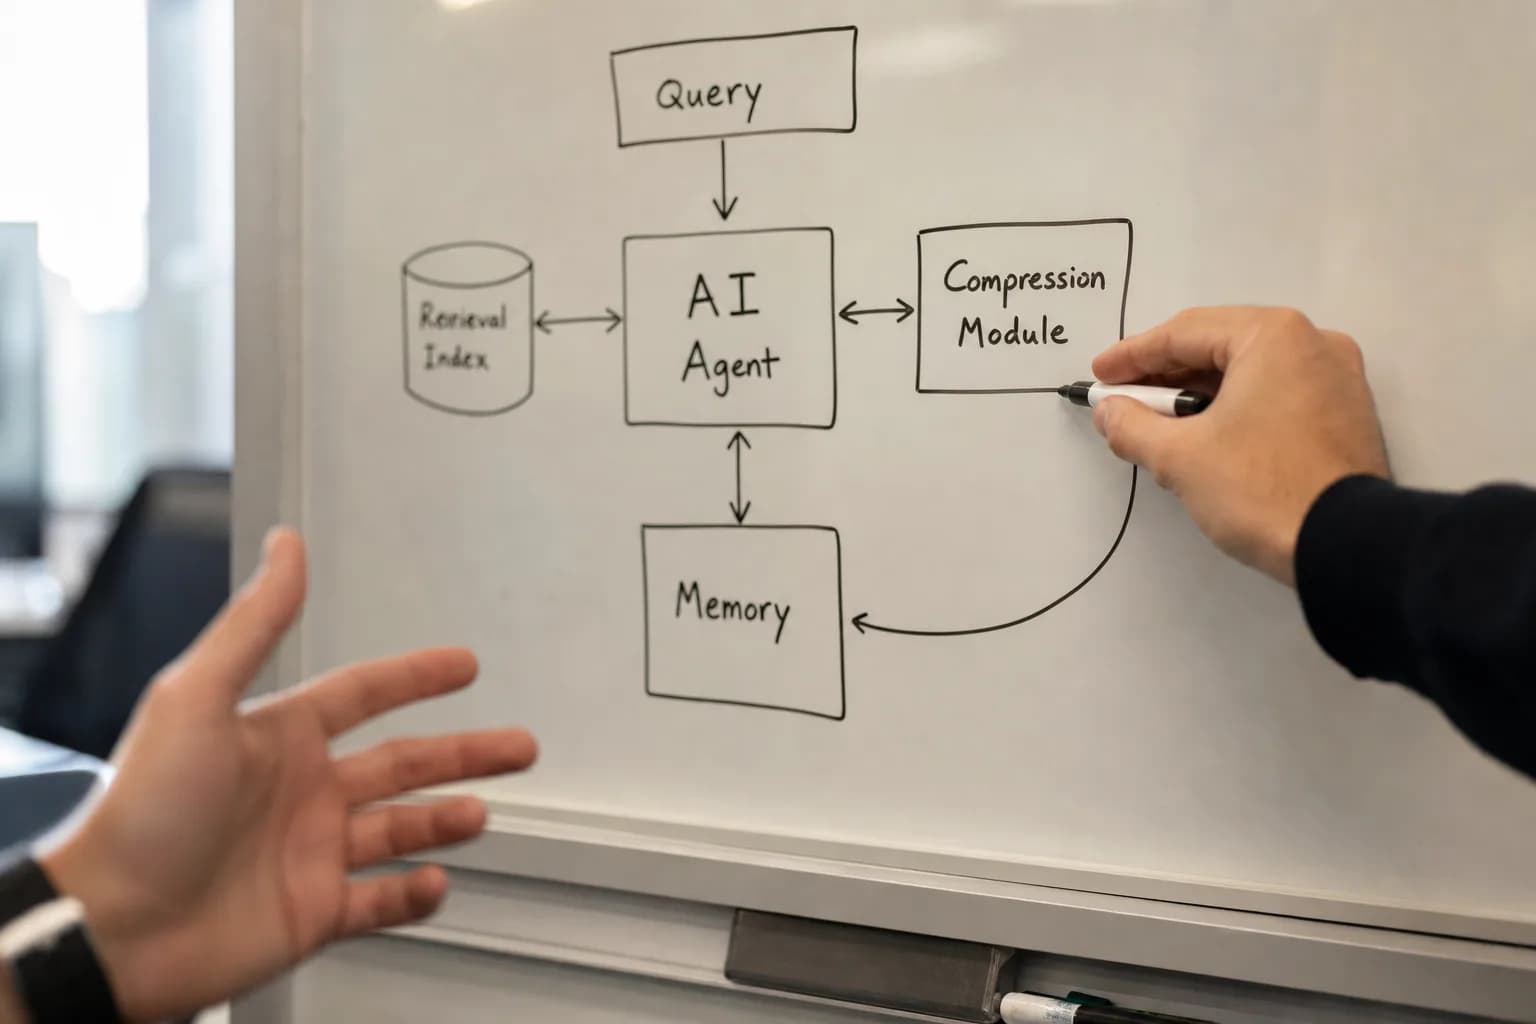
ברמת הארכיטקטורה, LangChain פירמלה ארבע אסטרטגיות שהפכו למסגרת החשיבה המקובלת: write (שמירת קונטקסט במאגר חיצוני), select (אחזור רלוונטי ב-RAG), compress (סיכום ודחיסה של היסטוריה) ו-isolate (הפרדת קונטקסטים בין סוכנים כדי שלא יזהמו זה את זה). צוות ה-Applied AI של Anthropic מציע חלוקה משלימה לשלוש קטגוריות: קונטקסט סטטי, אחזור דינמי וניהול משימות ארוכות-טווח, עם עיקרון מנחה אחד: קבוצת הטוקנים הקטנה ביותר עתירת-הסיגנל שממקסמת את התוצאה הרצויה.
מהפרומפט לתוכנית: הגישה של DSPy
המהלך הרעיוני הגדול של השנה הוא המעבר מכתיבת פרומפטים לכתיבת תוכניות. DSPy מייצג את הגישה שבה לא כותבים פרומפט ידני אלא מגדירים חתימות מוקלדות (signatures) של קלט ופלט, והפרומפט עצמו הוא תוצר קומפילציה שמותאם אוטומטית למודל ולמשימה. הפריימינג הזה הופך לברירת המחדל ב-2026: הפרומפט הוא artifact שנוצר, נמדד ומעודכן, לא טקסט שמישהו מלטש ידנית.
import dspy

class SummarizeHebrew(dspy.Signature):
    """סכם מסמך עסקי בעברית לשלוש נקודות מרכזיות."""
    document: str = dspy.InputField()
    summary: str = dspy.OutputField(desc="3 bullets, Hebrew")

summarize = dspy.ChainOfThought(SummarizeHebrew)
result = summarize(document=doc_text)
בצד הסטנדרטיזציה, פרוטוקול MCP של Anthropic מנסה להגדיר כיצד קונטקסט עובר בין מודולי סוכנים, ויוזמת NIST AI Agent שהושקה השנה מכירה בכך שממשקי קונטקסט משותפים חיוניים לסוכנים מאובטחים ואינטרואופרביליים. מי שבונה תשתית סוכנים היום ומתעלם מהשכבה הזו יצטרך לשלם חוב טכני בהמשך.
למה זה משנה לצוותים בישראל
המספרים מהשטח מסבירים למה זה דחוף. לפי דו"ח State of Context Management 2026 של DataHub, 89% מהצוותים מתכננים להשקיע בתשתית ניהול קונטקסט ב-12 החודשים הקרובים, ו-92% צופים שההשקעה תגדל משנה לשנה. בצד הארגוני, 45% מהארגונים מתכננים להעביר GenAI לפרודקשן או לסקייל ב-2026, אבל רובם עדיין מעוכבים בגלל guardrails (76%) ומוכנות דאטה ארגונית (62%). כלומר: הביקוש למי שיודע לבנות שכבת קונטקסט אמינה גבוה בהרבה מההיצע.
לחברות ישראליות שעובדות בעברית יש שכבת מורכבות נוספת: טקסט עברי "יקר" יותר בטוקנים מאנגלית, כך שתקציב הקונטקסט מתכווץ מהר יותר. דחיסה וסיכום של היסטוריית שיחה, אחזור סלקטיבי במקום הדבקת מסמכים שלמים, ושימוש נכון ב-caching הם לא אופטימיזציה נחמדה אלא הבדל של עשרות אחוזים בחשבון ה-API החודשי.
התחילו קטן: מדדו כמה טוקנים באמת נכנסים לכל קריאה בפרודקשן. ברוב הצוותים שבדקו זאת לראשונה התגלה שחלק ניכר מהקונטקסט הוא היסטוריה ומסמכים שאיש לא צריך, וקיצוץ שלהם שיפר גם עלות וגם איכות.
מה הלאה
הכיוון ברור: הערך עולה במעלה הסטאק. סכמות, קריאות כלים, פריסות קונטקסט, evals ולולאות סוכנים הם המקומות שבהם נקבעת איכות המערכת, לא הניסוח של משפט הפתיחה. מי שבנה קריירה על שליטה בניסוחי פרומפטים צריך להסב אותה להנדסת מערכות: לחשוב על המודל כעל מעבד שהקלט שלו מתוכנן, נמדד ומנוהל בגרסאות. הפרומפט הטוב של 2026 הוא זה שאף אחד לא כתב ידנית.
שאלות נפוצות
מה ההבדל בין הנדסת פרומפטים להנדסת קונטקסט?
הנדסת פרומפטים עוסקת בניסוח ההוראה עצמה, בעוד הנדסת קונטקסט מתכננת את כל מה שהמודל רואה בקריאה: פרומפט מערכת, מסמכים שאוחזרו, היסטוריית שיחה, הגדרות כלים וזיכרון. ב-2026 זו המיומנות המרכזית, כי סוכנים נכשלים בניהול מצב ולא בניסוח.
האם עדיף פרומפט ארוך או קצר ב-2026?
קצר וממוקד. מחקרים מראים שביצועי היסק מתחילים להתדרדר כבר סביב 3,000 טוקנים, ונקודת המתיקות לרוב המשימות היא 150-300 מילים. גם עם חלונות של מיליון טוקנים, העיקרון הוא קבוצת הטוקנים הקטנה ביותר עתירת-הסיגנל.
איך מוזילים עלויות API בעבודה עם מודלי שפה?
שמרו על פרומפט מערכת קבוע כדי לנצל prompt caching, שחותך עד 90% מהעלות ו-85% מהלייטנסי על הקידומת המקובעת. בנוסף, אחזרו רק מסמכים רלוונטיים במקום להדביק הכול, דחסו היסטוריית שיחה, ונסו zero-shot לפני הוספת דוגמאות.
דרגו את הכתבה
הדירוג עוזר לנו לדעת מה שווה לכם.


תגובות