מחקר מבן־גוריון: מתי AI ראה מספיק וידאו כדי לענות?
חוקרים מבן־גוריון זיהו אות פנימי שמסייע לתזמן תשובות של מודלי וידאו־שפה. בניסוייהם השתפר הדיוק בעד 9.75 נקודות אחוז, בלי לאמן מחדש את המודלים.

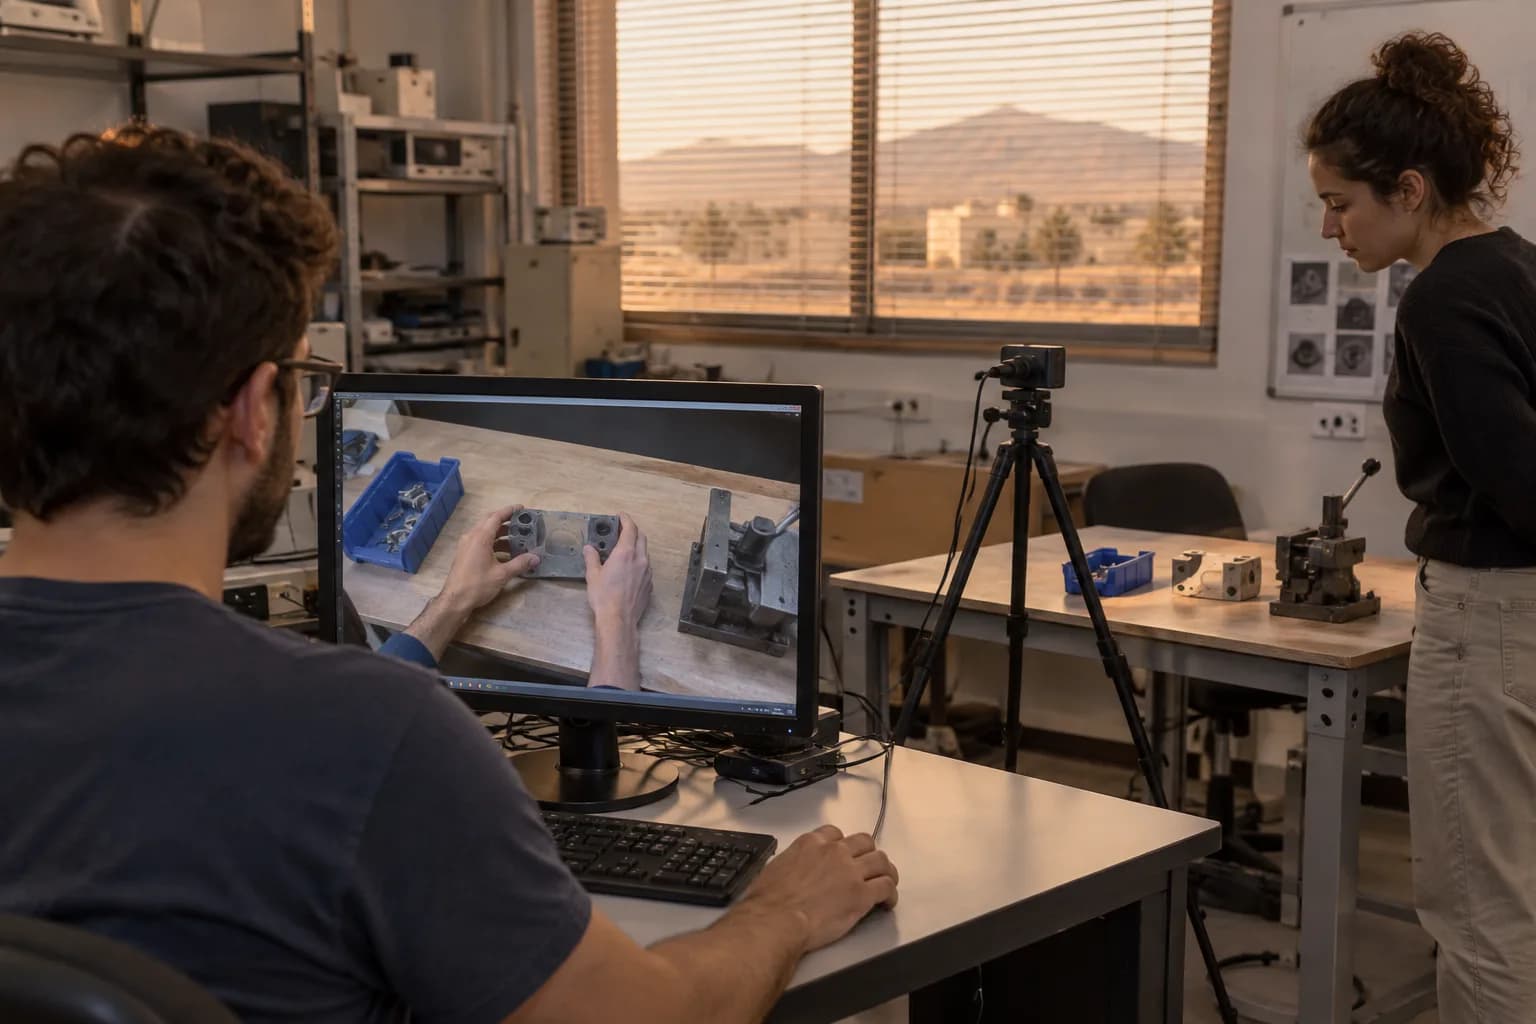
מערכת AI שצופה בסרטון יכולה לענות לפני שהאירוע שעליו נשאלה בכלל התרחש. מחקר חדש מאוניברסיטת בן־גוריון מציע לזהות מתוך פעילות המודל אם כבר הגיע המידע החזותי הדרוש, ולהשתמש באות הזה כדי להחליט מתי לענות. לפי החוקרים, תזמון כזה שיפר את הדיוק בעד 9.75 נקודות אחוז באותו משך צפייה, בלי לאמן מחדש את המודלים עצמם.
מה נבדק: לא רק מה לענות, אלא מתי
ב־6 באוקטובר 2026 פרסמו דן בן־עמי, קובי כהן וחיים בסקין את המאמר Have I Seen Enough? ב־arXiv. המחקר בחן שבעה מודלי וידאו־שפה וזיהה בהם אות פנימי שמעיד אם כבר התקבל המידע החזותי הנחוץ לשאלה. על בסיס האות הזה מציעים החוקרים שיטה בשם Readiness Gating, שמשתמשת במוכנות המזוהה כדי לתזמן את התשובה.
הבעיה קלה להבנה באמצעות תרחיש המחשה: שואלים מערכת לאיזו מגירה הוכנס כלי עבודה, בזמן שהסרטון עדיין מציג אדם מחזיק אותו מעל השולחן. בשלב הזה גם זיהוי מושלם של האדם, הכלי והמגירות אינו מספיק. התשובה תלויה בפעולה שטרם נראתה, ולכן ניסוח משכנע עלול להיות פשוט ניחוש מוקדם.
מכאן נובעת ההבחנה המרכזית במחקר. אפשר לשאול אם מודל יודע לפרש את מה שראה, אבל קודם צריך לשאול אם הוא כבר ראה את מה שנדרש. אלו שאלות שונות: שיפור ביכולת התיאור אינו בהכרח פותר בעיה של מידע שעדיין לא הופיע. המחקר מתמקד בהחלטה על רגע המענה, ולא מציג אותה כתחליף להבנה חזותית.
מה עושה Readiness Gating, ומה אומר השיפור
לפי דיווח החוקרים, Readiness Gating משתמשת באות הפנימי כדי לתזמן תשובות, בלי לאמן מחדש את מודלי הווידאו־שפה עצמם. זו נקודה חשובה למפתחים: ההתערבות המתוארת עוסקת באופן שבו משתמשים במודל בזמן הצפייה. עם זאת, מהתחקיר לבדו אי אפשר להסיק מה נדרש כדי לשלב את השיטה בכל מערכת, או אם אפשר להפעיל אותה דרך שירות חיצוני שאינו חושף את פעילותו הפנימית.
התוצאה המדווחת היא שיפור של עד 9.75 נקודות אחוז בדיוק, באותו משך צפייה. הניסוח הזה משמעותי: השיפור אינו מוצג כתוצאה של מתן זמן צפייה נוסף, אלא של שימוש באות לתזמון המענה. במקביל, המילה ״עד״ מציינת את השיפור המרבי המדווח, ולא ממוצע שאפשר לייחס לכל שבעת המודלים או לכל סוגי השאלות.
- מה נבחן: אות פנימי בשבעה מודלי וידאו־שפה, המעיד על הגעת המידע החזותי הדרוש לשאלה.
- מה השתנה: תזמון התשובה באמצעות Readiness Gating, בלי לאמן מחדש את המודלים עצמם.
- מה דווח: שיפור בדיוק של עד 9.75 נקודות אחוז באותו משך צפייה.
- מה לא הוכח: שהאות מבטיח תשובה נכונה, או שאותו שיפור יתקבל בכל מוצר ובכל סביבת צילום.
נכון ל־8 באוקטובר 2026, אלו תוצאות שהחוקרים מדווחים עליהן במאמר חדש ב־arXiv, ולא אימות עצמאי של הביצועים. גם ההבדל בין נקודות אחוז לאחוזי שיפור חשוב: אין להציג את הנתון המדווח כשיפור יחסי של 9.75%.
מוכנות לענות אינה הוכחה שהתשובה נכונה
גם אחרי שהכלי הוכנס למגירה, המודל יכול לטעות: לבלבל בין צדדים, לפרש לא נכון את השאלה או לתאר פעולה אחרת. הדוגמאות האלה ממחישות מדוע אות של מוכנות אינו שקול לבדיקת נכונות. הוא עוסק בשאלה אם הגיע המידע הנדרש, ולא מבטיח שהעיבוד שלו יסתיים בתשובה אמינה.
״כבר ראיתי מספיק כדי לענות״ ו״התשובה שלי נכונה״ הן שתי טענות שונות.
לכן לא נכון לתאר את המחקר כפתרון להזיות. התרומה המצומצמת יותר היא גם המעניינת יותר: ניסיון לזהות מצב שבו עצם המענה מוקדם מדי. מבחינת תכנון מערכת, זה מציע להפריד בין ההחלטה להמתין לעוד מידע לבין ההחלטה אם לסמוך על התשובה שהתקבלה. הצלחה בהחלטה הראשונה אינה מבטלת את הצורך לבדוק את השנייה.
למה זה רלוונטי למוצרים ולעסקים בישראל
מעבר לזיקה הישירה לבן־גוריון, יש כאן שאלה מעשית לצוותים ישראליים שמפתחים מערכות המבוססות על וידאו. בתרחיש אפשרי של בקרת תהליך במפעל, למשל, מערכת עשויה להישאל אם עובד השלים פעולת הרכבה. אם היא עונה לפני שהשלב המכריע נראה במצלמה, גם יכולת תיאור טובה אינה מספיקה. המתנה מבוססת מידע עשויה להיות שימושית יותר מתשובה מיידית.
דוגמה נוספת היא סיוע מרחוק לטכנאי: השאלה אינה רק אם המערכת מזהה את הרכיב, אלא אם כבר ראתה את תוצאת הפעולה שביצע. אלו שימושים אפשריים, לא יישומים שהוכחו בתחקיר. עסק בישראל שרוצה לבחון את הכיוון צריך להשתמש בסרטונים המייצגים את תנאי העבודה שלו, ולבדוק בנפרד שאלות בעברית במקום להניח שהממצאים עוברים אליה ללא שינוי.
בבדיקה כזו כדאי להבחין בין מענה מוקדם, המתנה מיותרת ותשובה שגויה לאחר שהמידע כבר הופיע. שלוש התקלות פוגעות במוצר בדרכים שונות. מערכת שממתינה תמיד אינה בהכרח מועילה, ומערכת שמגיבה מיד אינה בהכרח יעילה. בנוסף, במקומות עבודה יש לבחון הרשאות צילום, פרטיות וגישה לתיעוד בנפרד משאלת הביצועים של המודל.
מה צריך לבדוק לפני מעבר ממאמר למוצר
השלב הבא מבחינת מי ששוקל לאמץ את הרעיון הוא לבדוק עד כמה האות נשאר שימושי מחוץ לניסויים המתוארים. שאלות חשובות הן כיצד הוא מתנהג כשפרט חיוני מוסתר, כשהשאלה עמומה או כשהמידע הדרוש כלל אינו מופיע בסרטון. במצב האחרון, התנהגות רצויה עשויה להיות הודאה בחוסר מידע, ולא המתנה שבסופה תשובה לא מבוססת.
לצוותי מחקר ופיתוח, נקודת המוצא היא קריאת [המאמר Have I Seen Enough?](https://arxiv.org/html/2610.08560v1) ובחינת תנאי הניסויים לפני הסקת מסקנות על מוצר מסוים. המסר המרכזי אינו ש־AI כבר יודע מתי הוא צודק, אלא שאפשר לחקור בנפרד אם הגיע הרגע שבו יש לו מספיק מידע חזותי כדי לנסות לענות. זו הבחנה שימושית במיוחד במערכות שאמורות לפעול תוך כדי התרחשות, ולא רק לסכם אותה בדיעבד.
שאלות נפוצות
מה זה Readiness Gating במודלי וידאו־שפה?
Readiness Gating היא שיטה שמשתמשת באות פנימי של המודל כדי לתזמן תשובה בהתאם להגעת המידע החזותי הדרוש לשאלה. במחקר מבן־גוריון היא נבחנה בלי לאמן מחדש את המודלים עצמם, ושיפרה את הדיוק בניסויים בעד 9.75 נקודות אחוז באותו משך צפייה.
האם המחקר מבן־גוריון פותר הזיות של AI בווידאו?
לא. האות שנחקר מעיד על הגעת המידע החזותי הדרוש, אך אינו מבטיח שהמודל יפרש אותו נכון או יפיק תשובה נכונה. התרומה היא בתזמון התשובה ובצמצום תשובות מוקדמות מדי, ולא באימות מלא של התוכן.
האם השיטה נבדקה בשאלות בעברית?
התחקיר שסופק אינו מפרט בדיקה של שאלות בעברית, ולכן אי אפשר להסיק ממנו על הביצועים בשפה זו. לפני שימוש במוצר ישראלי צריך לבדוק את תזמון התשובות ואת נכונותן בנפרד על שאלות וסרטונים שמייצגים את השימוש בפועל.
דרגו את הכתבה
הדירוג עוזר לנו לדעת מה שווה לכם.
תגובות