אנבידיה חושפת את Vera: מעבד ראשון עם ליבות בעיצוב עצמי
בכנס Hot Chips 2026 חשפה אנבידיה את ארכיטקטורת Vera: 88 ליבות Olympus בעיצוב עצמי, האצה בעומסי סוכני AI, ותגובה חריפה מ-AMD.

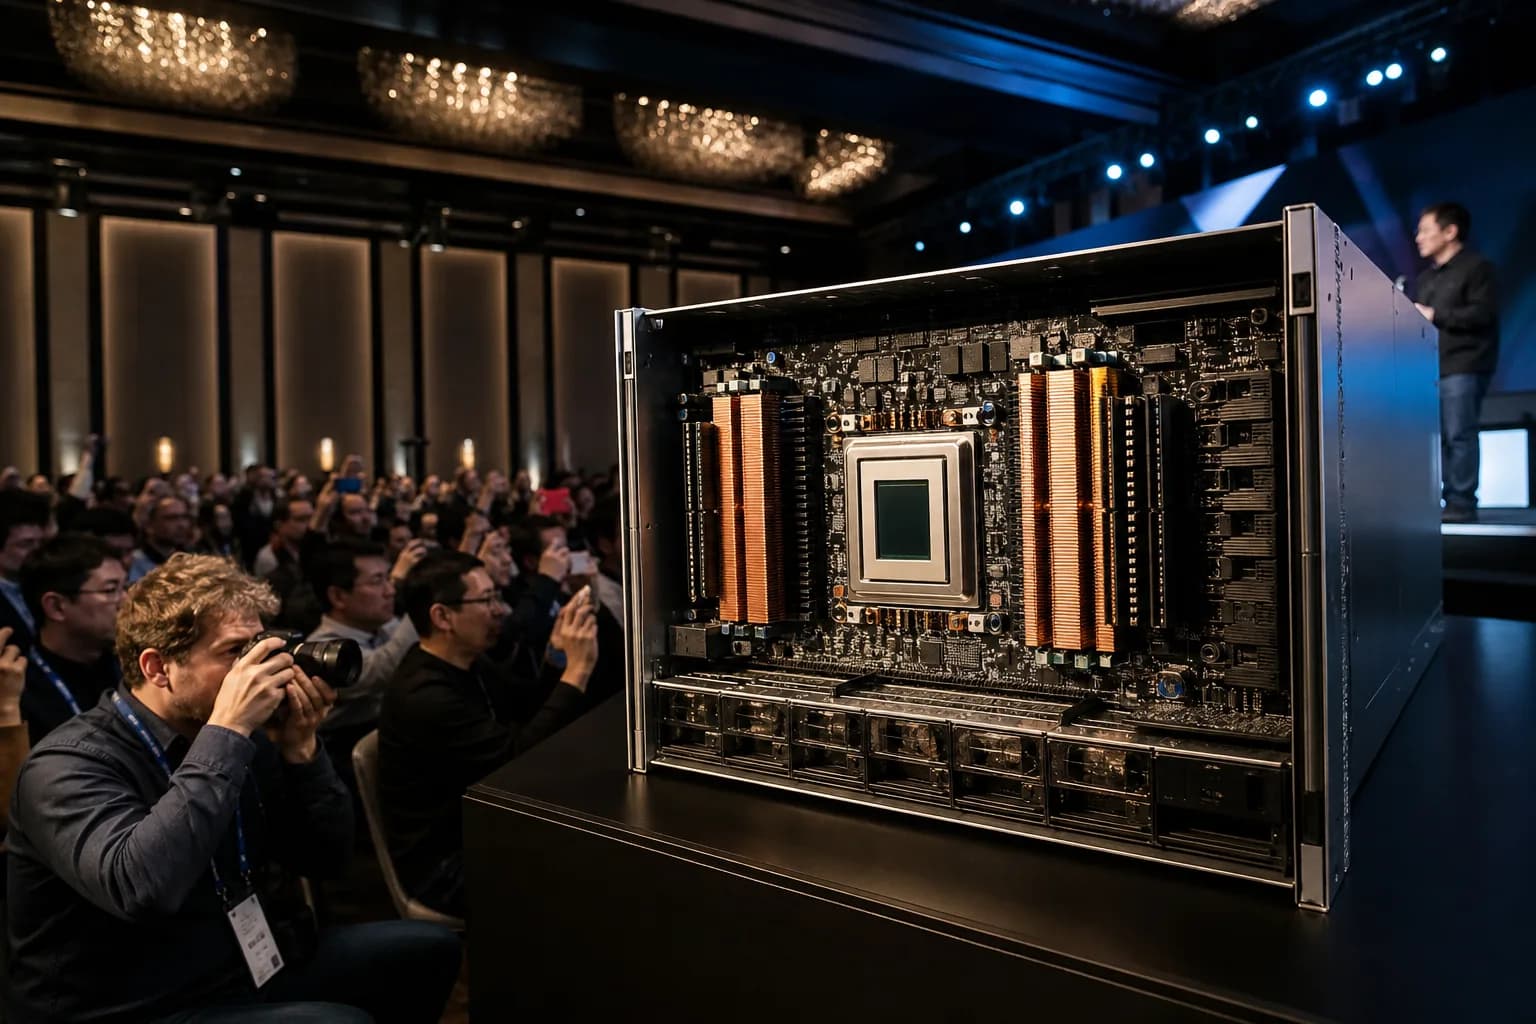
אנבידיה עלתה לבמה בכנס Hot Chips 2026 ב-24 באוגוסט וחשפה לראשונה את הארכיטקטורה הפנימית של מעבד Vera, המעבד הראשון שלה עם ליבה בעיצוב עצמי מלא. החברה טוענת להאצה של כ-1.8x בעומסי עבודה של סוכני AI לעומת הדור הקודם, ו-AMD כבר הספיקה להגיב עם טענות נגד. המלחמה על הדאטה-סנטר האג'נטי יצאה רשמית לדרך.
מה נחשף בכנס: 88 ליבות Olympus על שישה צ'יפלטים
בלב Vera יושבות 88 ליבות בשם Olympus, ליבות מותאמות אישית שאנבידיה עיצבה בעצמה, המחולקות על שישה צ'יפלטים שמורכבים יחד על אינטרפוזר אחד. זו נקודת מפנה אסטרטגית: מעבד Grace, קודמו של Vera, עוד השתמש בעיצוב ליבות סטנדרטי של Arm. הפעם אנבידיה לקחה את השליטה על כל הסטאק, מהליבה ועד הרשת.
לצד הליבות, Vera מגיע עם זיכרון LPDDR5X ועם ממשק NVLink-C2C שמחבר את המעבד ישירות ל-GPU או לזוג מעבדים נוספים. השילוב הזה נועד לצמצם את צוואר הבקבוק הקלאסי בין ה-CPU ל-GPU, שהופך קריטי במיוחד כשמערכות אג'נטיות מריצות אלפי קריאות קצרות ואינטראקטיביות במקום עומסי אימון ארוכים וצפויים.
- 88 ליבות Olympus בעיצוב עצמי של אנבידיה, על שישה צ'יפלטים ואינטרפוזר אחד
- זיכרון LPDDR5X ו-NVLink-C2C לחיבור ישיר ל-GPU או לזוג מעבדים
- האצה של כ-1.8x בעומסי סוכני AI לעומת הדור הקודם, לפי אנבידיה
- עד פי 30 בתפוקה לעומת Grace Blackwell בתרחישי אינטראקטיביות מסוימים
למה "דאטה-סנטר אג'נטי" הוא שם המשחק
אנבידיה לא מסתירה את הכיוון: Vera ממוקד במפורש במה שהיא מכנה דאטה-סנטרים אג'נטיים. בעוד אימון מודלים דורש בעיקר כוח חישוב גולמי ב-GPU, הרצת סוכני AI בפרודקשן היא משחק אחר לגמרי: המון בקשות קצרות, תזמור בין כלים, קריאות רשת וזיכרון, והרבה עבודה שנופלת דווקא על ה-CPU. מעבד שתוכנן מהיסוד לתרחיש הזה יכול להיות ההבדל בין סוכן שמגיב בשנייה לסוכן שמגיב בעשר.
החשיפה מצטרפת להודעה נוספת של אנבידיה מאותם ימים: מאיץ ההסקה הייעודי Groq 3 LPX, פרי רכישת הכישרונות של Groq ב-20 מיליארד דולר, נכנס לייצור מלא ומשתלב בפלטפורמת Vera Rubin עם עד 256 מאיצים לכל rack. ספקית הענן Nebius תהיה הלקוחה הראשונה שתפרוס racks של LPX לצד מעבדי Vera. התמונה המצטיירת ברורה: אנבידיה בונה "מפעל AI" שבו צ'יפים, רשתות ומערכות מתוכננים כיחידה אחת.
AMD יורה בחזרה: Venice עם 256 ליבות
התגובה של AMD לא איחרה להגיע. החברה טוענת שמעבד Venice שלה, המבוסס על ארכיטקטורת Zen 6 ומגיע עם 256 ליבות, מנצח את Vera פי 3.3 בביצועים ברמת ה-rack. חשוב לשים לב לניסוח: AMD מדברת על ביצועי rack שלם ולא על ליבה מול ליבה, ואנבידיה מצדה מדגישה תרחישים אג'נטיים ספציפיים. כל צד בוחר את הבנצ'מרק שנוח לו.
ההשוואות האלה הן פחות מדע ויותר שיווק. השאלה האמיתית היא כמה עולה טוקן בפרודקשן, כמה מהר הוא מגיע, ומי נותן לך את זה בלי לנעול אותך לאקוסיסטם אחד.
Vera הוא המעבד הראשון של אנבידיה עם ליבה בעיצוב עצמי. עבור Arm זו חרב פיפיות: אנבידיה עדיין בונה על סט הפקודות של Arm, אבל כבר לא תלויה בעיצובי הליבות שלה.
מה זה אומר לחברות ולמפתחים בישראל
לרוב הסטארטאפים הישראלים אין ולא יהיה rack של Vera במשרד, אבל ההשלכות יגיעו דרך הענן. כשספקיות כמו Nebius מתחילות לפרוס את הפלטפורמה החדשה, המחירים והביצועים של הסקת מודלים (inference) ישתנו, ודווקא בכיוון שמעניין חברות ישראליות רבות: עומסים אג'נטיים. חברות ליגלטק, פינטק וסייבר בארץ שבונות סוכנים על גבי מודלים קיימים ירגישו את זה קודם כל בזמני תגובה ובעלות לטוקן.
יש כאן גם שיעור ארכיטקטוני למי שמתכנן תשתית: ההנחה שה-CPU הוא רק "מתאם" ליד ה-GPU כבר לא נכונה. צוותים שמריצים סוכנים בהיקף גדול צריכים למדוד היום איפה הזמן באמת מתבזבז אצלם, כי ייתכן שדווקא צד ה-CPU והרשת הם צוואר הבקבוק, בדיוק הבעיה ש-Vera מנסה לפתור.
מה הלאה: הקרב עובר לרמת ה-rack
החשיפה ב-Hot Chips היא רק פתיחה. בחודשים הקרובים נראה את הבנצ'מרקים העצמאיים הראשונים, את התמחור בפועל אצל ספקיות הענן, ואת התשובה של AMD בשטח ולא רק במצגות. דבר אחד כבר ברור: היחידה הבסיסית של תחרות בשוק תשתיות ה-AI היא כבר לא השבב אלא ה-rack השלם, וכל מי שבונה מוצרי AI, גם מתל אביב, ישלם או ירוויח מהתוצאה.
שאלות נפוצות
מה ההבדל בין מעבד Vera של אנבידיה למעבד Grace?
Grace השתמש בעיצוב ליבות סטנדרטי של Arm, בעוד Vera הוא המעבד הראשון של אנבידיה עם ליבות Olympus בעיצוב עצמי. Vera כולל 88 ליבות על שישה צ'יפלטים, זיכרון LPDDR5X ו-NVLink-C2C, ואנבידיה טוענת להאצה של כ-1.8x בעומסי סוכני AI לעומת הדור הקודם.
מה זה דאטה-סנטר אג'נטי?
מרכז נתונים שמותאם להרצת סוכני AI בפרודקשן ולא רק לאימון מודלים. עומסים אג'נטיים כוללים המון בקשות קצרות, תזמור כלים וקריאות רשת, ולכן דורשים איזון שונה בין CPU, GPU, זיכרון ורשת לעומת עומסי אימון קלאסיים.
האם Venice של AMD באמת מהיר יותר מ-Vera?
AMD טוענת ש-Venice מבוסס Zen 6 עם 256 ליבות מנצח את Vera פי 3.3 בביצועים ברמת ה-rack, אבל כל חברה מודדת בתרחישים שנוחים לה. עד שיפורסמו בנצ'מרקים עצמאיים על חומרה אמיתית, כדאי להתייחס למספרים משני הצדדים בזהירות.
דרגו את הכתבה
הדירוג עוזר לנו לדעת מה שווה לכם.
תגובות