OpenAI חושפת מצב Ultrafast: GPT-5.6 Sol במהירות פי 14
OpenAI השיקה שכבת שירות Ultrafast שמריצה את GPT-5.6 Sol עד פי 14 מהר יותר בעזרת Cerebras, עם 750 טוקנים לשנייה. מה זה אומר למפתחים בישראל?

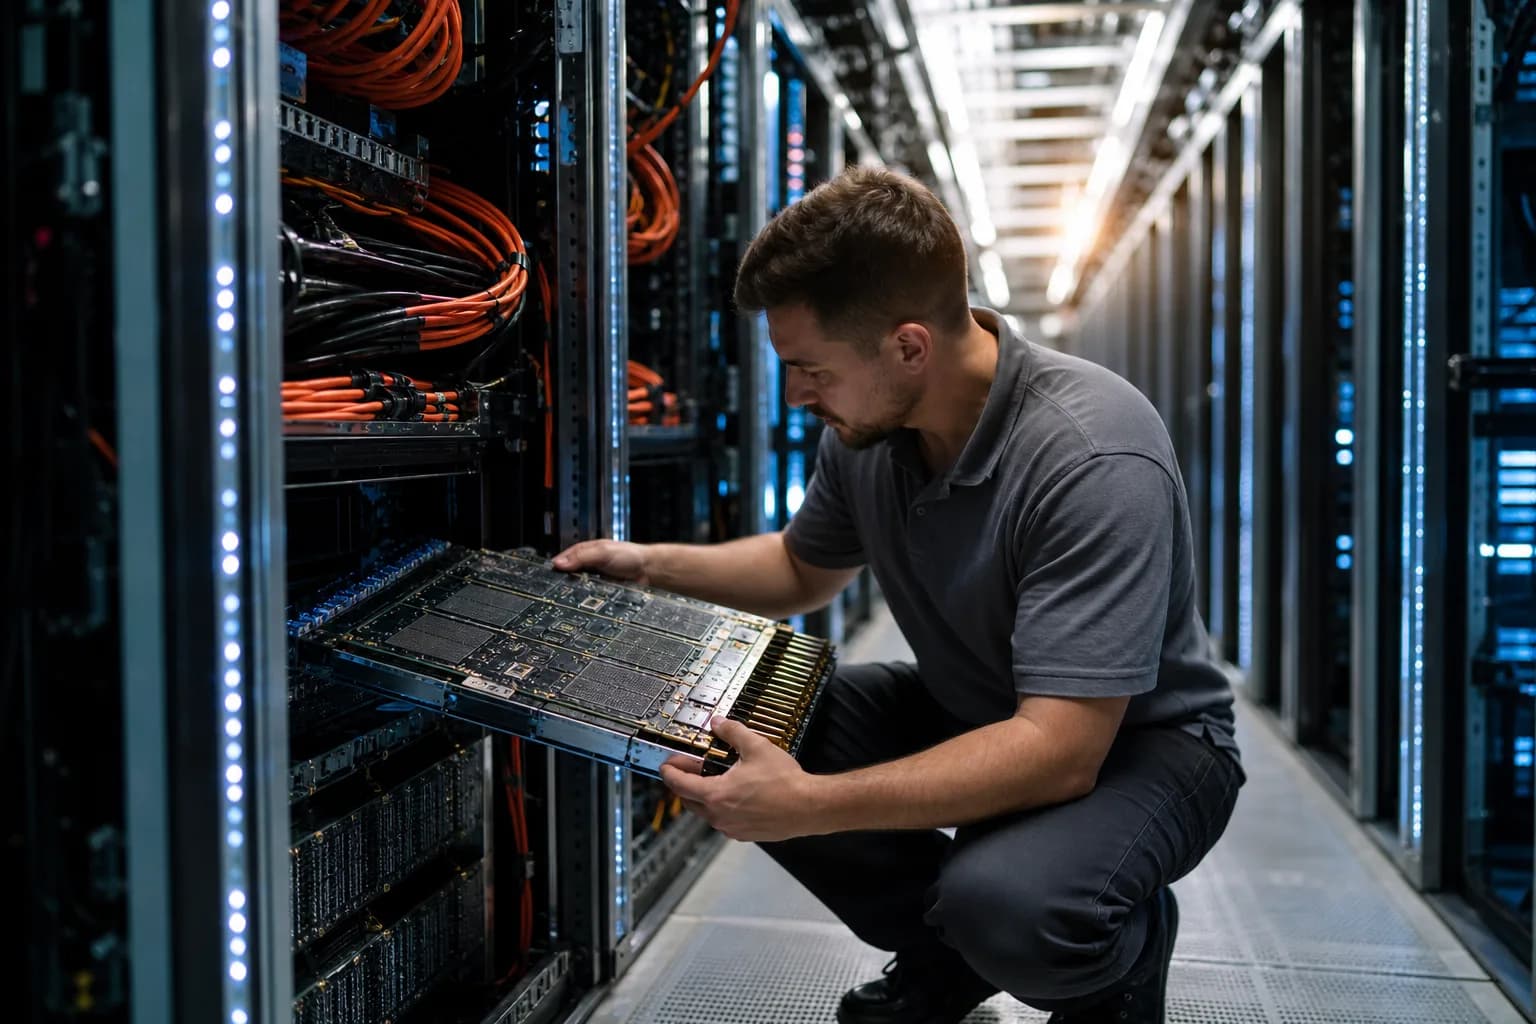
OpenAI הציגה אתמול (13 באוגוסט) הצצה מוקדמת ל-Ultrafast, שכבת שירות חדשה ב-API שמריצה את GPT-5.6 Sol עד פי 14 מהר יותר מהעיבוד הסטנדרטי, עם קצב של עד 750 טוקנים לשנייה. מאחורי הביצועים עומדת חומרה של Cerebras, והמסר של OpenAI ברור: מעכשיו לא צריך לבחור בין המודל החכם ביותר לבין מהירות תגובה.
מה בדיוק הושק, ואיך זה עובד
Ultrafast היא לא מודל חדש אלא שכבת שירות (service tier) שמפעילה את אותו GPT-5.6 Sol שכבר מוכר למפתחים, רק על תשתית אחרת לגמרי. במקום מקבצי GPU קונבנציונליים, השכבה רצה על מעבדי Cerebras, שבנויים סביב שבבים בקנה מידה של Wafer שלם ומתמחים בדיוק בזה: הזרמת טוקנים בקצב גבוה במיוחד עם זמן תגובה נמוך.
ההשקה מתחילה ב-API של OpenAI, כלומר קהל היעד הראשוני הוא מפתחים ולא משתמשי ChatGPT. OpenAI ממצבת את השכבה ליישומים שבהם כל עשירית שנייה נספרת: מחקר פיננסי, תגובה לאירועים בזמן אמת, תמיכת לקוחות, יישומי קול, מסחר וניסויים חיים בפרודקשן.
מדובר בהצצה מוקדמת (preview): הזמינות, המכסות והתמחור הסופי עשויים להשתנות עד ההשקה הרחבה. מי שבונה על Ultrafast מערכת קריטית כדאי שיתכנן מסלול fallback לשכבה הסטנדרטית.
למה זה שינוי אמיתי ולא עוד שיפור נקודתי
עד עכשיו, מפתחים שנזקקו למהירות אמת נאלצו להתפשר: לבחור מודל קטן וזול יותר, לעבוד עם מודל ייעודי למשימות קלות, או לבנות ארכיטקטורה מסובכת שמנתבת שאילתות פשוטות למודל מהיר ושאילתות מורכבות למודל חכם. Ultrafast מבטלת את הדילמה הזאת, לפחות על הנייר: אותה איכות של מודל הדגל, בקצב שמתאים לשיחה קולית שוטפת.
המשמעות האמיתית היא בארכיטקטורה. צוותים שבנו שכבות ניתוב שלמות רק כדי לחסוך ב-latency יכולים פתאום לפשט את כל המערכת ולעבוד עם מודל אחד
יש כאן גם סיפור עסקי מעניין: OpenAI, שמזוהה כמעט לגמרי עם התשתית של Microsoft Azure ועם GPU של NVIDIA, בוחרת בספקית חומרה חלופית עבור שכבת שירות מסחרית. זה אות לכך שבתחרות על ה-inference המהיר, ארכיטקטורות ייעודיות כמו של Cerebras מתחילות לתפוס מקום של ממש לצד ה-GPU הקלאסי.
הזווית הישראלית: מי מרוויח מזה בארץ
האקוסיסטם הישראלי בנוי בדיוק על התחומים ש-OpenAI מציינת כיעדים של Ultrafast. חברות פינטק ומסחר אלגוריתמי, סטארטאפים של Voice AI ומוקדי שירות, וחברות סייבר שצריכות תגובה לאירועים בזמן אמת, כולם נתקלו עד היום באותו קיר: מודל הדגל היה איטי מדי לאינטראקציה חיה.
- יישומי קול בעברית: סוכן קולי לשירות לקוחות חייב להגיב תוך פחות משנייה כדי להישמע טבעי. עם 750 טוקנים לשנייה, אפשר להריץ את המודל החזק ביותר גם בשיחה חיה.
- פינטק ומסחר: ניתוח דוחות, חדשות ואיתותים בזמן אמת בלי לוותר על עומק הניתוח של GPT-5.6 Sol.
- תמיכת לקוחות בסקייל: צ'אטבוטים שמרגישים מיידיים גם בשעות עומס, בלי לרדת למודל חלש יותר.
- SOC וסייבר: תחקור התרעות ותגובה לאירועים, תחום שבו כל שנייה של המתנה למודל עולה כסף אמיתי.
לצוותי פיתוח בארץ שכבר עובדים עם ה-API של OpenAI, המעבר צפוי להיות פשוט יחסית: אותו מודל, אותם prompts, רק בחירת service tier אחרת. זה אומר שאפשר להתחיל בניסוי מצומצם על endpoint אחד רגיש ל-latency ולמדוד את ההבדל בפועל, בלי לשכתב לוגיקה.
ההקשר התחרותי: מרוץ המהירות מתחמם
ההכרזה נוחתת בשוק שבו המהירות הפכה לחזית תחרות בפני עצמה. Cerebras וספקיות inference ייעודיות אחרות הציעו כבר קצבים גבוהים, אבל בעיקר על מודלים פתוחים או קטנים. החידוש כאן הוא החיבור: מודל הדגל הסגור והחזק של OpenAI, על החומרה המהירה ביותר בשוק, תחת חוזה שירות אחד.
בשוק סוכני הקידוד, שבו GPT-5.6 Sol ו-Claude Opus 5 צמודים כמעט לחלוטין במדדים העדכניים, מהירות עשויה להפוך לגורם המכריע. סוכן שמסיים איטרציה של קוד תוך שניות במקום דקות משנה את חוויית העבודה מהיסוד, וסביר שנראה את המתחרות מגיבות עם שכבות מהירות משלהן.
מתלבטים אם Ultrafast רלוונטי לכם? בדקו את היחס בין זמן ההמתנה למודל לבין שאר ה-pipeline. אם רוב ה-latency שלכם מגיע מ-retrieval, רשת או עיבוד מקדים, שדרוג המודל לבדו לא יורגש אצל המשתמש.
מה הלאה
השאלות הפתוחות המרכזיות הן תמחור וזמינות: OpenAI טרם פרסמה מחירון מלא לשכבה, ולא ברור מתי היא תיפתח לכלל המפתחים ובאילו מכסות. שאלה נוספת היא האם Ultrafast יגיע גם למוצרי הקצה כמו ChatGPT, או יישאר יתרון של בוני יישומים דרך ה-API.
כך או כך, הכיוון ברור: הדור הבא של התחרות בין מודלי הדגל לא ייקבע רק במדדי איכות, אלא גם בשאלה מי מספק את אותה איכות מהר יותר וזול יותר. עבור מפתחים ישראלים שבונים מוצרי זמן אמת, שווה לעקוב מקרוב ולהיערך לניסוי מוקדם ברגע שהגישה תיפתח.
שאלות נפוצות
מה זה מצב Ultrafast של OpenAI?
Ultrafast היא שכבת שירות חדשה ב-API של OpenAI שמריצה את GPT-5.6 Sol עד פי 14 מהר יותר מהעיבוד הסטנדרטי, בקצב של עד 750 טוקנים לשנייה. היא מופעלת על חומרה של Cerebras והוצגה כהצצה מוקדמת ב-13 באוגוסט 2026.
למי מיועדת שכבת Ultrafast?
השכבה מיועדת ליישומים שבהם זמן תגובה קריטי: יישומי קול, תמיכת לקוחות, מחקר פיננסי, מסחר, תגובה לאירועים וניסויים חיים. היא זמינה תחילה למפתחים דרך ה-API ולא במוצרי הקצה כמו ChatGPT.
האם Ultrafast משתמש במודל חלש יותר כדי להשיג מהירות?
לא. מדובר באותו GPT-5.6 Sol, מודל הדגל של OpenAI, שרץ על תשתית חומרה ייעודית של Cerebras. זו הפעם הראשונה שאין צורך לבחור בין המודל החכם ביותר לבין מהירות תגובה גבוהה.
דרגו את הכתבה
הדירוג עוזר לנו לדעת מה שווה לכם.
תגובות