BDH-CQ: מודל 150 מיליון פרמטרים שחושב בלי לכתוב מילה
מעבדת Pathway חשפה את BDH-CQ, מודל היסק זעיר שמשיג 29.5% ב-ARC-AGI-1 בעלות של $0.0007 למשימה, בלי שרשרת מחשבה טקסטואלית. למה זה מסעיר את קהילת המחקר.

מעבדת Pathway מפאלו אלטו פרסמה ב-11 באוגוסט תוצאות שמאתגרות את ההנחה הבסיסית של תעשיית ההיסק: המודל BDH-CQ, עם 150 מיליון פרמטרים בלבד, השיג 29.5% pass@2 על סט ההערכה הציבורי של ARC-AGI-1 בעלות של $0.0007 למשימה. לשם השוואה, GPT-5.6 Luna במצב Low משיג 34.2% במחיר של $0.040 למשימה, כלומר פי 57 יותר. הפער בדיוק קטן; הפער בעלות עצום.
מה בעצם קרה: חשיבה בלי טוקנים
הטריק המרכזי של BDH-CQ הוא ויתור מוחלט על שרשרת המחשבה הטקסטואלית שהפכה לסטנדרט במודלי היסק. במקום לפלוט טוקנים של reasoning, המערכת מבצעת איטרציות במרחב לטנטי רב-ממדי ומעדכנת זיכרון רקורנטי ישירות מההדגמות שהיא רואה. במילים פשוטות: המודל "חושב" בתוך הייצוגים הפנימיים שלו, בלי לתרגם כל שלב ביניים לשפה.
הגישה הזו חוסכת את העלות הכבדה ביותר במודלי היסק מודרניים, שבהם רוב החשבון בענן נשרף על הפקת אלפי טוקנים של מחשבה שהמשתמש בכלל לא רואה. כשהחישוב נשאר במרחב הלטנטי, מספר הפרמטרים הקטן והיעדר פלט הביניים מצטברים ליתרון עלות דרמטי.
ARC-AGI-1 הוא benchmark של חידות הפשטה ויזואליות שנחשב עמיד במיוחד בפני שינון: כל משימה דורשת זיהוי חוקיות חדשה מכמה הדגמות בלבד, ולכן הוא משמש מדד מקובל ליכולת הכללה ולא לזיכרון.
האימות החיצוני ששינה את השיחה
טענות על מודלים קטנים שמכים את הגדולים צצות כל כמה שבועות, ורובן מתפוגגות בבדיקה. כאן הסיפור שונה: לוקאש קייזר, ממחברי מאמר הטרנספורמר המקורי מ-2017, שחזר את התוצאות בעצמו ואישר אותן פומבית. לדבריו, הארכיטקטורה, ולא רק הסקייל, יכולה להוביל את הקפיצה הבאה בהיסק.
כולם מחפשים את הדרך להוריד את עלות ההיסק בסדר גודל בלי לוותר על איכות. אם חשיבה לטנטית מוכיחה את עצמה מעבר ל-ARC, זו הכתובת שכולם ירוצו אליה
למה חזית העלות-דיוק חשובה יותר מהשיא
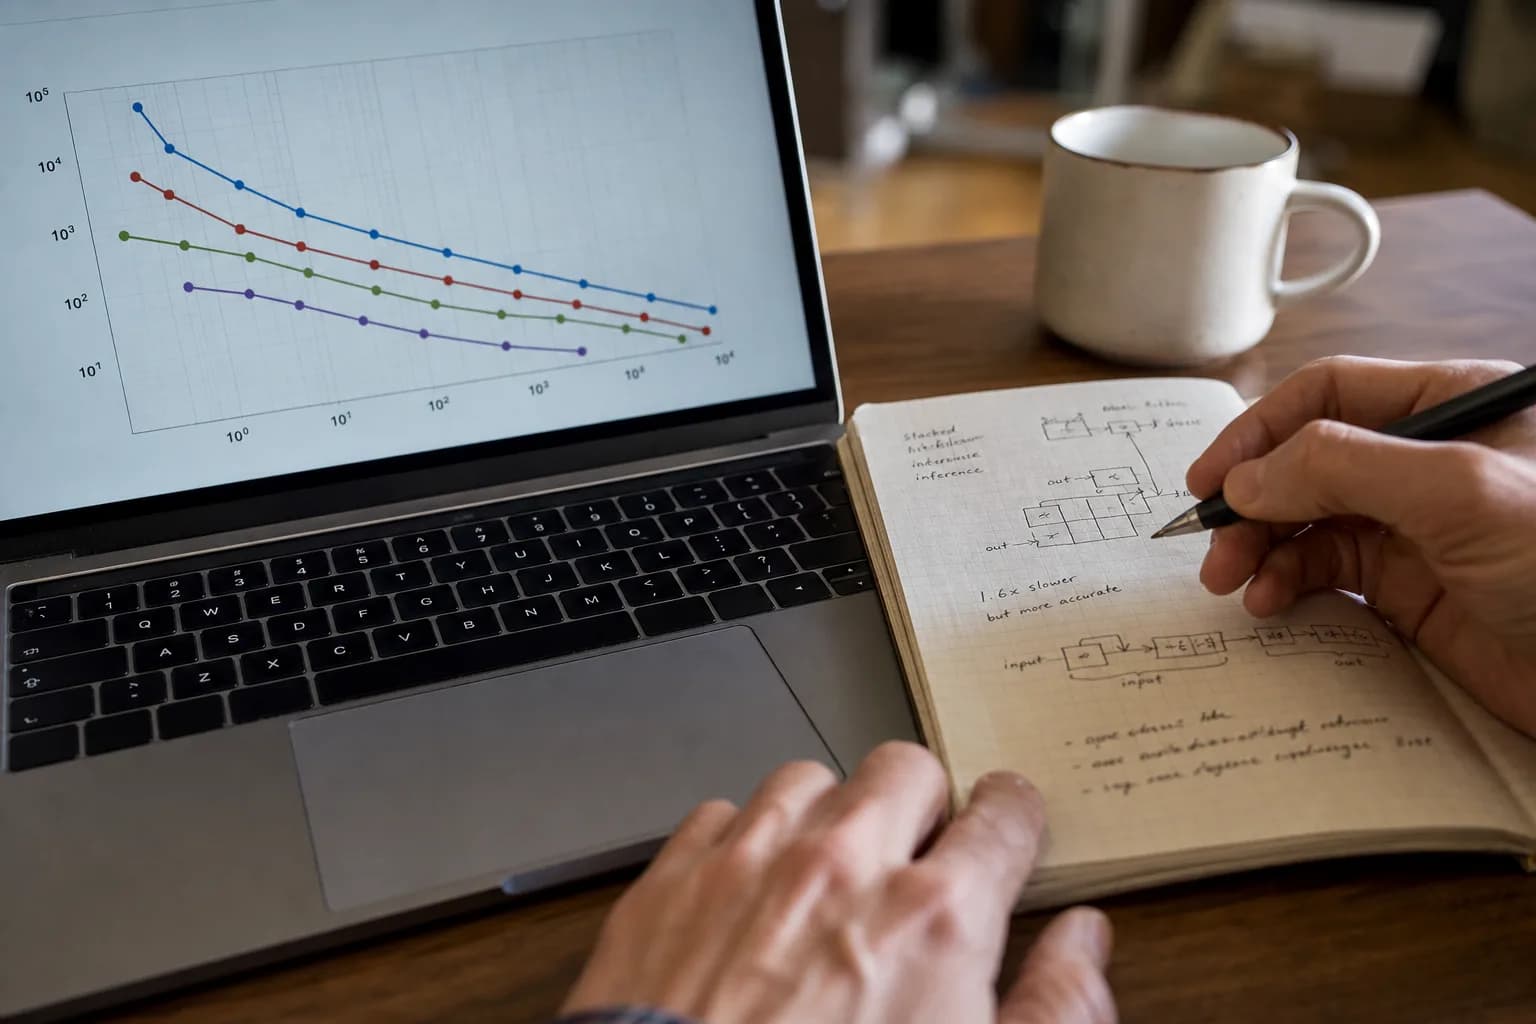
מאז שקרן ARC Prize החלה לפרסם את נתוני העלות לצד הציונים, השיח במחקר עבר מ"מי הכי מדויק" ל"מי מדויק ביחס למחיר". על פי נתוני יולי 2026, BDH-CQ לא שובר את שיא הדיוק, אבל הוא מזיז את כל חזית העלות-דיוק: נקודה חדשה בגרף שאף מודל אחר לא מתקרב אליה.
- עלות: $0.0007 למשימה מול $0.040 של GPT-5.6 Luna (Low), פער של פי ~57
- גודל: 150 מיליון פרמטרים, סדרי גודל פחות מהמודלים המובילים
- שיטה: איטרציות במרחב לטנטי וזיכרון רקורנטי במקום שרשרת מחשבה טקסטואלית
- אימות: שחזור עצמאי של התוצאות על ידי לוקאש קייזר
יש גם מגבלות שכדאי לזכור. ARC-AGI-1 הוא benchmark אחד, ויכולת הכללה בחידות הפשטה לא מתורגמת אוטומטית למשימות שפה, קוד או סוכנים. בנוסף, מודל שחושב במרחב לטנטי מקריב שקיפות: אין שרשרת מחשבה קריאה שאפשר לבקר, מה שמקשה על debugging ועל מחקר בטיחות. השאלה הפתוחה היא אם הגישה תשרוד סקייל-אפ למשימות מציאותיות.
הזווית הישראלית: היסק זול הוא משחק אחר
עבור סטארטאפים ישראלים שבונים מוצרים על גבי מודלי היסק, עלות ה-inference היא לרוב סעיף ההוצאה הכבד ביותר אחרי כוח אדם. מודל של 150 מיליון פרמטרים שמבצע reasoning אמיתי הוא בשורה כפולה: הוא זול להרצה בענן, וקטן מספיק לרוץ על חומרה מקומית או on-premise, תרחיש קריטי לחברות בתחומי הביטחון, הפיננסים והבריאות בארץ שלא יכולות לשלוח נתונים החוצה.
גם לקהילת המחקר המקומית יש כאן הזדמנות. אם הקפיצה הבאה תגיע מארכיטקטורה ולא מסקייל, כפי שטוען קייזר, מעבדות אקדמיות בטכניון, בתל אביב ובאוניברסיטה העברית, שאין להן תקציבי אימון של מיליארדי דולרים, חוזרות להיות שחקניות רלוונטיות בחזית. מודל של 150 מיליון פרמטרים אפשר לאמן ולחקור בתקציב אקדמי סביר.
מה הלאה
המבחן האמיתי של BDH-CQ יהיה מחוץ ל-ARC: האם חשיבה לטנטית מכלילה למתמטיקה, לקוד ולמשימות סוכניות, והאם הארכיטקטורה נשארת יעילה כשמגדילים אותה. אם התשובה חיובית, המעבדות הגדולות יצטרכו להסביר למה הן שורפות דולרים על טוקנים של מחשבה שאיש לא קורא. אם לא, זו תישאר תוצאה אלגנטית על benchmark אחד. כך או כך, נקודת הייחוס לעלות היסק זזה, וקשה לראות אותה חוזרת אחורה.
שאלות נפוצות
מה זה BDH-CQ של Pathway?
BDH-CQ הוא מודל היסק בן 150 מיליון פרמטרים ממעבדת Pathway בפאלו אלטו, שפורסם באוגוסט 2026. הוא מבצע חשיבה באיטרציות במרחב לטנטי עם זיכרון רקורנטי, במקום להפיק שרשרת מחשבה טקסטואלית, ומשיג 29.5% pass@2 על ARC-AGI-1 בעלות של $0.0007 למשימה.
מה ההבדל בין חשיבה לטנטית לשרשרת מחשבה (Chain of Thought)?
בשרשרת מחשבה המודל פולט טוקנים של טקסט המתארים כל שלב בהיסק, מה שמייקר משמעותית את ההרצה. בחשיבה לטנטית העיבוד מתבצע בתוך הייצוגים הפנימיים של המודל ללא הפקת טקסט ביניים, מה שחוסך עלות אך מקריב שקיפות.
האם BDH-CQ טוב יותר מהמודלים הגדולים?
לא בדיוק במונחי דיוק: GPT-5.6 Luna (Low) משיג 34.2% על ARC-AGI-1 לעומת 29.5% של BDH-CQ. אבל BDH-CQ זול פי כ-57 למשימה, ולכן הוא קובע נקודה חדשה בחזית העלות-דיוק שאף מודל אחר לא מתקרב אליה כרגע.
דרגו את הכתבה
הדירוג עוזר לנו לדעת מה שווה לכם.
תגובות