מודל שפה קטן שמאמן את עצמו: שיטת Self-Distillation חדשה מ-MIT
חוקרים מ-MIT מציגים Recursive Self-Distillation: מודל קטן מייצר דאטה, verifier מסנן, והמודל משתפר בלי מודל-מורה יקר. למה זה חשוב למפתחים בישראל.

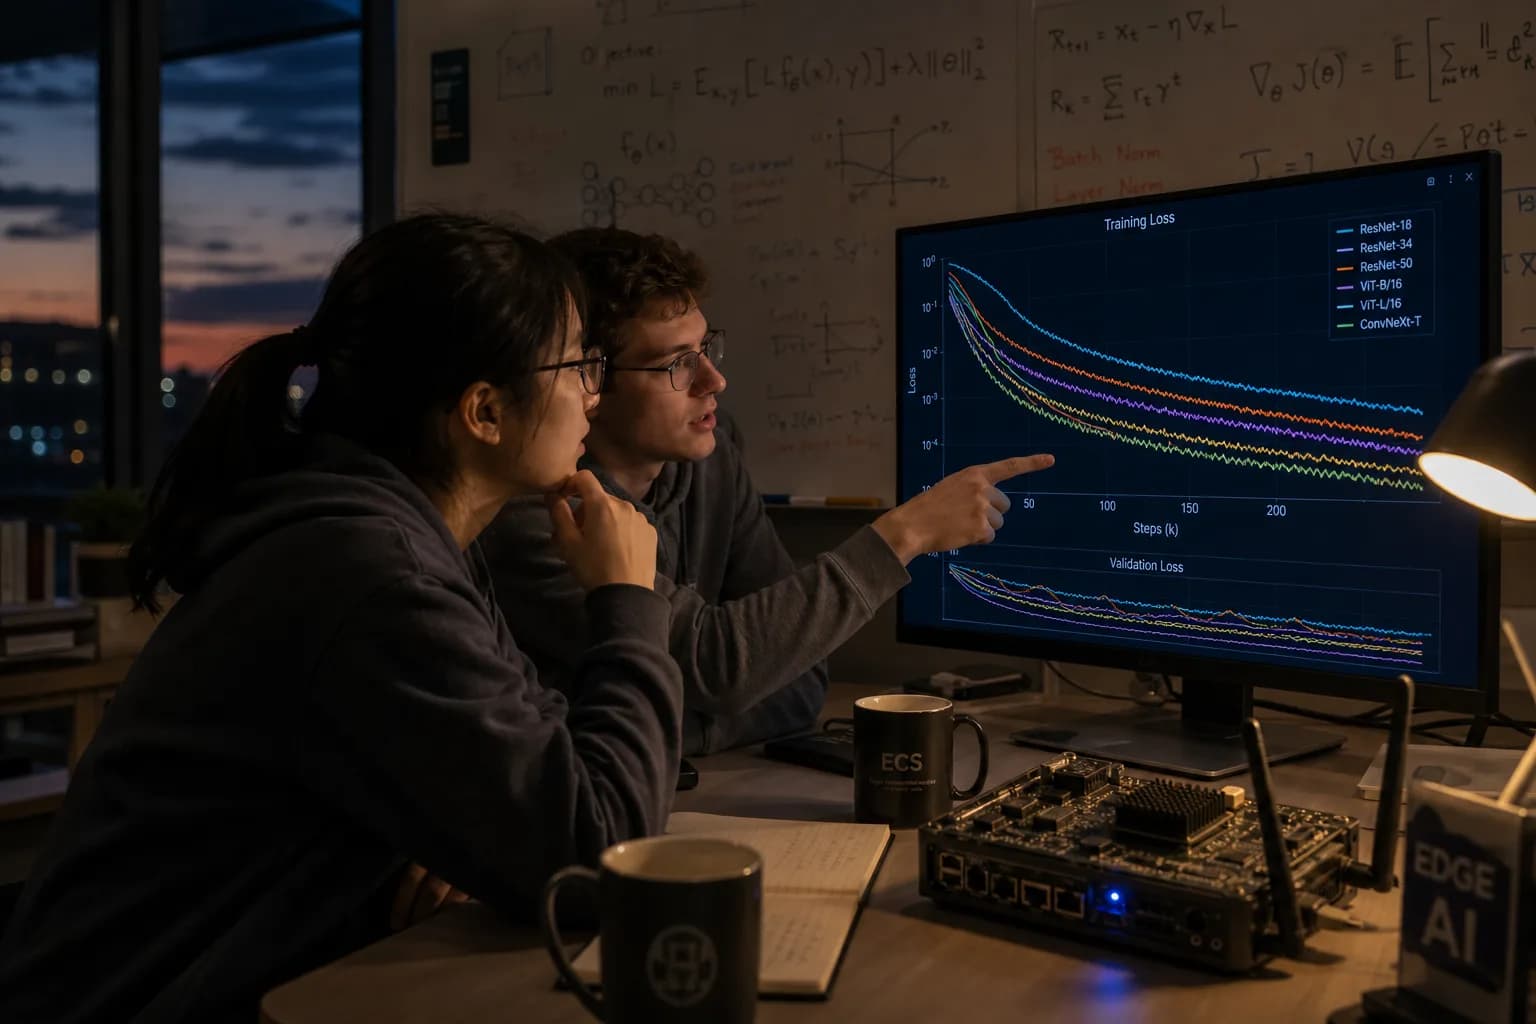
קבוצת חוקרים מ-MIT פרסמה השבוע מאמר שמציע לוותר על אחד הרכיבים היקרים ביותר בבניית מודלים קטנים: המודל-המורה. השיטה, שהחוקרים מכנים Recursive Self-Distillation, מאפשרת למודל של פחות מ-10 מיליארד פרמטרים לשפר את הביצועים של עצמו באמצעות תהליך איטרטיבי של יצירת דאטה, סינון וא fine-tuning עצמי. אם התוצאות יחזיקו מעמד בבדיקות חיצוניות, מדובר בחדשות מצוינות למי שמריץ מודלים על מכשירי קצה או בענן פרטי.
מה בעצם הציגו החוקרים
עד היום, הדרך המקובלת לייצר מודל קטן וחזק הייתה distillation קלאסי: לוקחים מודל ענק, מייצרים איתו מיליוני דוגמאות איכותיות, ומאמנים עליהן מודל קטן. הבעיה ברורה. גישה למודל-מורה חזק עולה הרבה כסף ב-API, או דורשת תשתית GPU שרוב הצוותים פשוט לא מחזיקים. המאמר החדש מציע לולאה סגורה: המודל הקטן מייצר בעצמו פתרונות למשימות, מנגנון verifier נפרד וזול מסנן את הפלטים השגויים, והמודל מתאמן מחדש רק על הדוגמאות ששרדו את הסינון.
החידוש המרכזי אינו הרעיון עצמו, שגרסאות שלו הופיעו בספרות עוד לפני שנתיים, אלא היציבות. ניסיונות קודמים ב-self-training נטו לקרוס אחרי שניים או שלושה סבבים: המודל התחיל לחזק את הטעויות של עצמו, תופעה שמכונה בספרות model collapse. החוקרים טוענים שהם פתרו את זה באמצעות שילוב של שני מנגנונים: verifier מבוסס-כללים במשימות שניתן לבדוק אוטומטית (קוד ומתמטיקה), ודגימה מחדש של חלק קטן מדאטת הבסיס המקורית בכל סבב, מה ששומר על עוגן ומונע סחיפה.
למה זה שונה מ-distillation רגיל
- אין תלות במודל-מורה: כל התהליך רץ על המודל הקטן עצמו, בלי קריאות API למודלים סגורים ובלי מגבלות רישוי על פלטים שלהם.
- עלות חישוב נמוכה משמעותית: לפי המאמר, סבב שיפור מלא דורש סדר גודל של עשרות שעות GPU בודדות, לא אלפי שעות.
- שיפור ממוקד-דומיין: הלולאה עובדת הכי טוב במשימות עם אימות אוטומטי, ולכן היא מתאימה במיוחד להתמחות בקוד, SQL או חישובים.
- מגבלה כנה: במשימות פתוחות כמו כתיבה שיווקית או סיכום, שבהן אין verifier אובייקטיבי, השיפור שנמדד היה קטן בהרבה.
ההקשר: הקרב על מכשירי הקצה
המאמר נוחת ברגע מעניין. השוק כולו נע לכיוון מודלים קטנים שרצים לוקאלית: אפל דוחפת מודלים קניינים למכשירים, גוגל מקימה בישראל קבוצת שבבי Edge AI, וגם בצד הענן המחירים של מודלים גדולים ממשיכים להכתיב את הכלכלה של כל מוצר. בעולם שבו כל קריאת API נספרת, מודל קטן שמתמחה בדיוק במשימה שלכם, ושאפשר לשפר אותו בלי לשלם לספק חיצוני, הוא נכס אמיתי.
הרעיון של מודל שמלמד את עצמו נשמע כמו קסם, אבל בפועל הקסם נמצא ב-verifier. מי שיודע לבנות מנגנון אימות טוב לדומיין שלו יכול להוציא ממודלים קטנים הרבה יותר ממה שנהוג לחשוב.
מה זה אומר למפתחים ולסטארטאפים בישראל
בישראל יש ריכוז גבוה במיוחד של חברות שבונות מוצרים סביב דומיינים צרים וניתנים לאימות: סייבר, פינטק, כלי DevOps וניתוח דאטה. אלה בדיוק התחומים שבהם הלולאה של המאמר מבטיחה את השיפורים הגדולים ביותר. סטארטאפ שמריץ היום מודל קטן בענן פרטי בגלל דרישות רגולציה או פרטיות, למשל בתחומי בריאות ופיננסים, יכול לבנות תהליך שיפור מתמשך בלי להוציא דאטה רגיש החוצה ובלי תלות בספק מודלים חיצוני.
יש כאן גם זווית תקציבית פשוטה. צוותים ישראלים קטנים שמתלבטים בין fine-tuning על מודל פתוח לבין תשלום שוטף על מודל ענק דרך API מקבלים עכשיו אופציה שלישית: להתחיל ממודל פתוח קטן, ולהשקיע את עיקר המאמץ ההנדסי בבניית verifier איכותי לדומיין. זו עבודה של שבועות, לא של חודשים, והיא לא דורשת קלאסטר.
אם אתם שוקלים לנסות את הגישה: התחילו מדומיין שבו אפשר לבדוק תשובות אוטומטית, כמו יצירת קוד עם טסטים או שאילתות SQL מול סכמה ידועה. בלי verifier אמין, לולאת האימון העצמי תחזק שגיאות במקום לתקן אותן.
מה הלאה: הסתייגויות ובדיקות שעוד חסרות
חשוב לשמור על פרופורציות. המאמר עדיין לא עבר ביקורת עמיתים מלאה, והתוצאות נמדדו בעיקר על בנצ'מרקים של קוד ומתמטיקה, שידועים כרגישים לזליגת דאטה. שאלה פתוחה נוספת היא כמה סבבים אפשר להריץ לפני שהשיפור מתמצה: החוקרים עצמם מדווחים על תשואה פוחתת אחרי מספר איטרציות. הקהילה כבר החלה בניסיונות שחזור על מודלים פתוחים, ובשבועות הקרובים נדע אם השיטה עמידה גם מחוץ למעבדה. אם כן, סביר שנראה אותה נכנסת מהר מאוד לכלי האימון הסטנדרטיים, בדיוק כפי שקרה לטכניקות distillation קודמות.
בינתיים, ההמלצה הפרקטית לצוותים בארץ היא לעקוב, ולהתחיל לחשוב על שאלת ה-verifier: איך בודקים אוטומטית שהפלט של המודל שלכם נכון? מי שיש לו תשובה טובה לשאלה הזאת מחזיק את המפתח, בין אם השיטה הספציפית הזאת תתפוס ובין אם הבאה בתור.
שאלות נפוצות
מה זה Self-Distillation במודלי שפה?
Self-Distillation היא טכניקה שבה מודל שפה מייצר בעצמו דוגמאות אימון, מנגנון סינון (verifier) מסיר את הפלטים השגויים, והמודל מתאמן מחדש על הדוגמאות שנותרו. כך המודל משתפר בלי צורך במודל-מורה גדול ויקר.
האם מודל קטן יכול להחליף מודל גדול כמו אלה שרצים בענן?
במשימות כלליות ופתוחות מודלים גדולים עדיין מובילים. אבל בדומיין צר וניתן לאימות, כמו יצירת קוד או SQL, מודל קטן שעבר התמחות יכול להגיע לביצועים תחרותיים בעלות נמוכה משמעותית וגם לרוץ לוקאלית.
מה זה model collapse ולמה זה מסוכן באימון עצמי?
Model collapse היא תופעה שבה מודל שמתאמן על פלטים של עצמו מתחיל לחזק את הטעויות שלו, והביצועים מתדרדרים מסבב לסבב. שיטות חדשות מתמודדות עם זה באמצעות verifier שמסנן פלטים שגויים ועיגון בדאטה מקורי בכל סבב.
דרגו את הכתבה
הדירוג עוזר לנו לדעת מה שווה לכם.
תגובות